
Trust, Don't Trust, or Flip: Robust Preference-Based Reinforcement Learning with Multi-Expert Feedback
, 2026年1月26日
3行要約
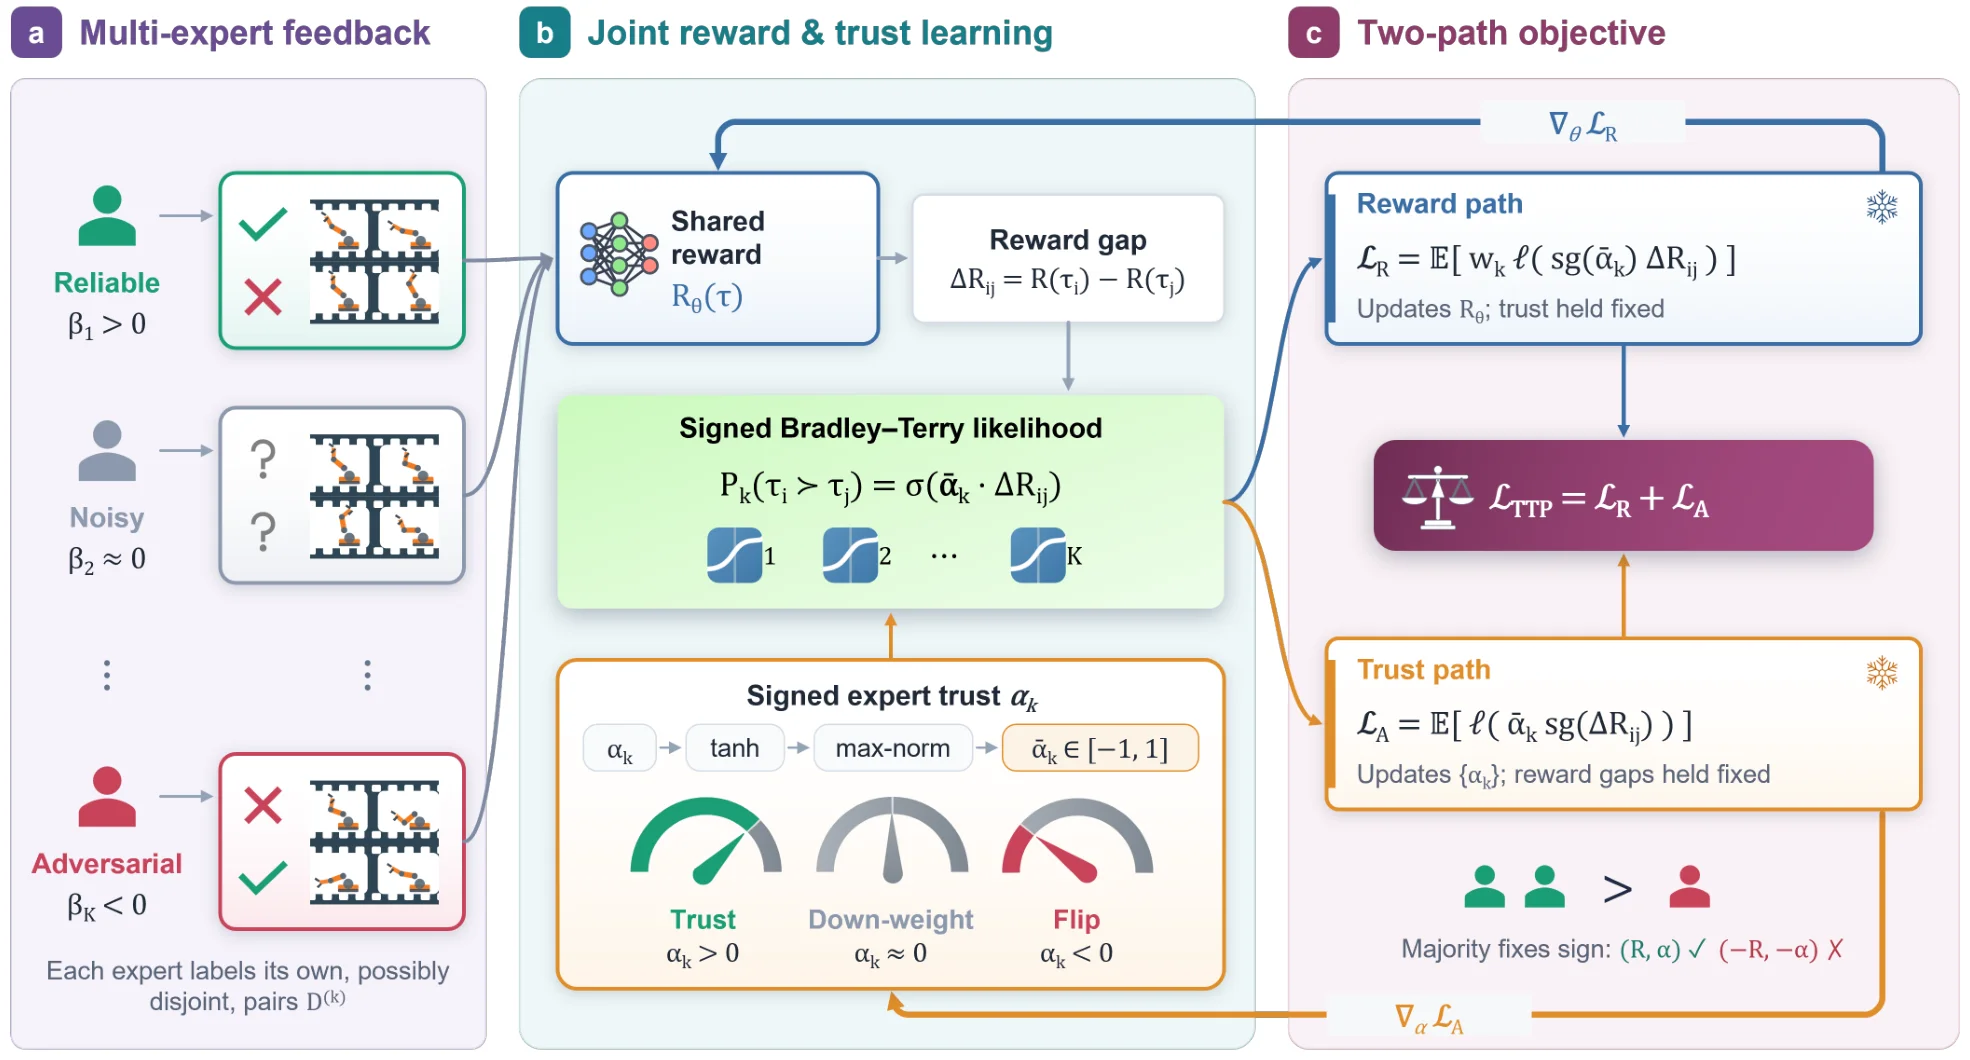
- TriTrust-PBRLは、信頼性が異なる複数の評価者による軌道のペア比較から報酬を学ぶ。
- 共有の報酬モデルと同時に、各評価者の選好を採用、抑制、反転する重みを学ぶ。
- 操作と移動の実験では、系統的に誤る評価者が混在しても学習性能を維持した。
論文の図
引用方法
S. A. Hosseini, M. Abdolali, A. Tavakkoli, F. Ayar, E. Javanmardi, M. Tsukada, and M. Javanmardi, “Trust, Don't Trust, or Flip: Robust Preference-Based Reinforcement Learning with Multi-Expert Feedback,” in , 2026.
BibTeX
@unpublished{Hosseini2026,
  title         = {Trust, Don't Trust, or Flip: Robust Preference-Based Reinforcement Learning with Multi-Expert Feedback},
  author        = {Seyed Amir Hosseini and Maryam Abdolali and Amirhosein Tavakkoli and Fardin Ayar and Ehsan Javanmardi and Manabu Tsukada and Mahdi Javanmardi},
  year          = {2026},
  date          = {2026-01-26},
  eprint        = {2601.18751},
  archiveprefix = {arXiv},
  primaryclass  = {cs.LG},
  url           = {https://arxiv.org/abs/2601.18751},
  note          = {Preprint}
}