
Trust, Don't Trust, or Flip: Robust Preference-Based Reinforcement Learning with Multi-Expert Feedback
, Jan 26, 2026
Summary in three lines
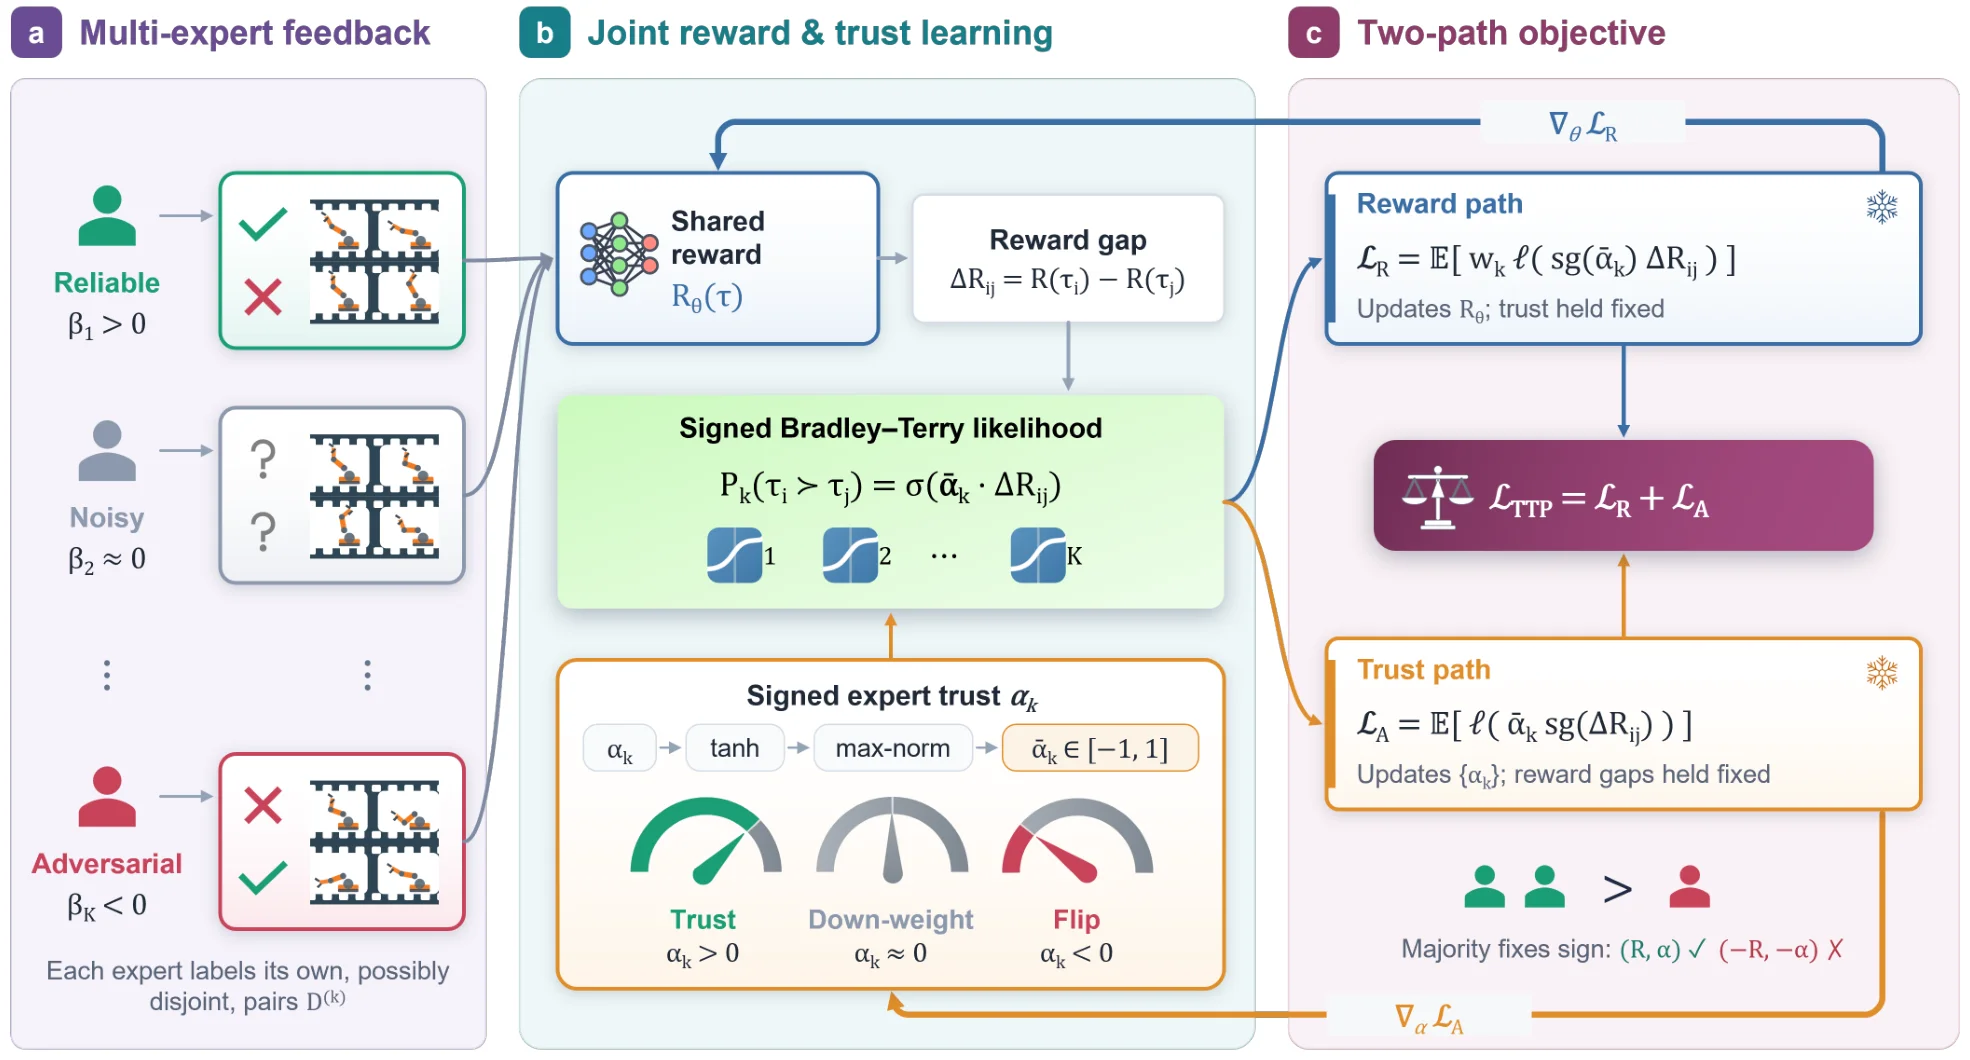
- TriTrust-PBRL learns rewards from pairwise preferences supplied by people or systems with different reliability.
- It learns when to use, downweight or reverse each expert’s feedback while fitting a shared reward model.
- Manipulation and locomotion experiments show robust learning even when the expert pool includes systematic errors.
Figures from the paper
How to cite
S. A. Hosseini, M. Abdolali, A. Tavakkoli, F. Ayar, E. Javanmardi, M. Tsukada, and M. Javanmardi, “Trust, Don't Trust, or Flip: Robust Preference-Based Reinforcement Learning with Multi-Expert Feedback,” in , 2026.
BibTeX
@unpublished{Hosseini2026,
  title         = {Trust, Don't Trust, or Flip: Robust Preference-Based Reinforcement Learning with Multi-Expert Feedback},
  author        = {Seyed Amir Hosseini and Maryam Abdolali and Amirhosein Tavakkoli and Fardin Ayar and Ehsan Javanmardi and Manabu Tsukada and Mahdi Javanmardi},
  year          = {2026},
  date          = {2026-01-26},
  eprint        = {2601.18751},
  archiveprefix = {arXiv},
  primaryclass  = {cs.LG},
  url           = {https://arxiv.org/abs/2601.18751},
  note          = {Preprint}
}