
QueenVIS: Rethinking Image-Only Training for Video Instance Segmentation via Query Enrichment
, 2026年7月27日
3行要約
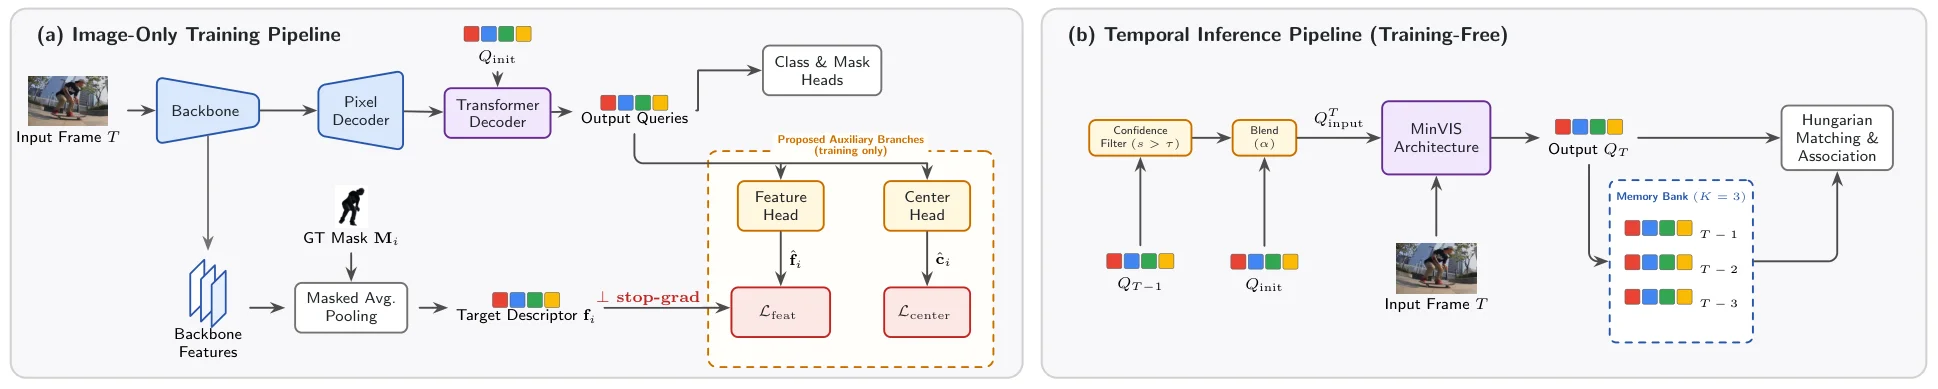
- QueenVISは物体クエリを改善し、単一画像で学習する動画インスタンス分割の性能を高める。
- 学習時に見た目と位置を予測し、推論時はクエリ伝搬とメモリでフレーム間の対応を保つ。
- ResNet-50構成のYouTube-VIS 2021で、MinVISの44.2 APを50.9 APに改善した。
論文の図
引用方法
A. Kheirandish, F. Ayar, E. Javanmardi, M. Tsukada, and M. Javanmardi, “QueenVIS: Rethinking Image-Only Training for Video Instance Segmentation via Query Enrichment,” in , 2026.
BibTeX
@unpublished{Kheirandish2026,
  title         = {QueenVIS: Rethinking Image-Only Training for Video Instance Segmentation via Query Enrichment},
  author        = {Arian Kheirandish and Fardin Ayar and Ehsan Javanmardi and Manabu Tsukada and Mahdi Javanmardi},
  year          = {2026},
  date          = {2026-07-27},
  eprint        = {2607.24598},
  archiveprefix = {arXiv},
  primaryclass  = {cs.CV},
  url           = {https://arxiv.org/abs/2607.24598},
  note          = {Preprint}
}