
QueenVIS: Rethinking Image-Only Training for Video Instance Segmentation via Query Enrichment
, Jul 27, 2026
Summary in three lines
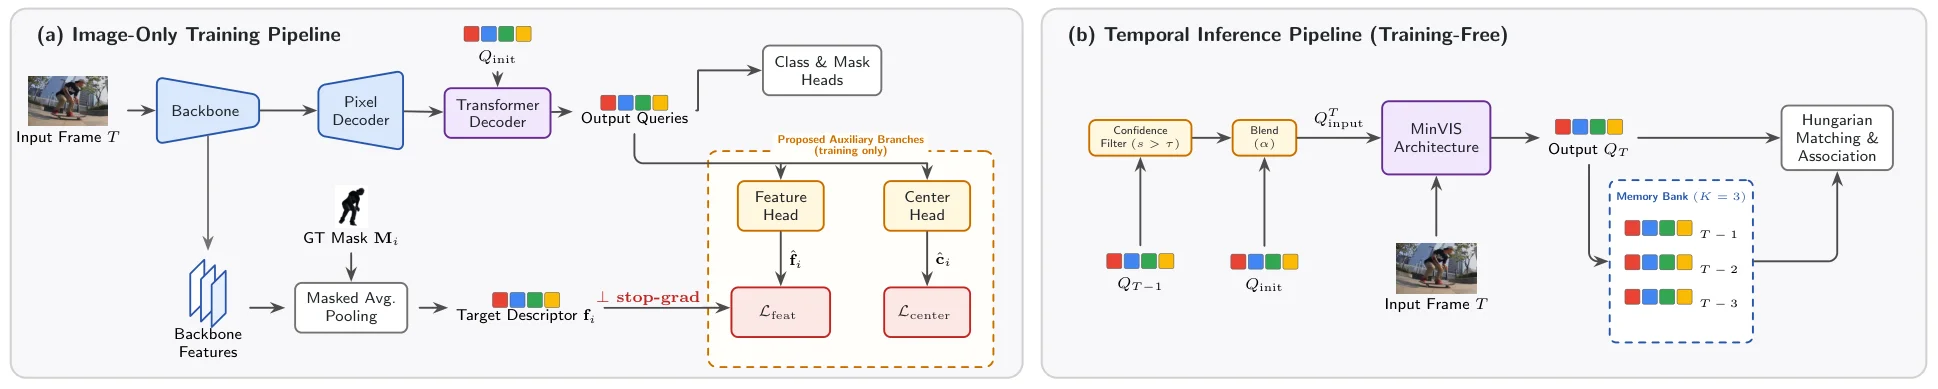
- QueenVIS trains video instance segmentation from individual images by enriching object queries.
- Training-only heads predict appearance and position, while query propagation and a memory bank maintain associations at inference.
- With ResNet-50, it raises YouTube-VIS 2021 AP from 44.2 to 50.9 versus MinVIS.
Figures from the paper
How to cite
A. Kheirandish, F. Ayar, E. Javanmardi, M. Tsukada, and M. Javanmardi, “QueenVIS: Rethinking Image-Only Training for Video Instance Segmentation via Query Enrichment,” in , 2026.
BibTeX
@unpublished{Kheirandish2026,
  title         = {QueenVIS: Rethinking Image-Only Training for Video Instance Segmentation via Query Enrichment},
  author        = {Arian Kheirandish and Fardin Ayar and Ehsan Javanmardi and Manabu Tsukada and Mahdi Javanmardi},
  year          = {2026},
  date          = {2026-07-27},
  eprint        = {2607.24598},
  archiveprefix = {arXiv},
  primaryclass  = {cs.CV},
  url           = {https://arxiv.org/abs/2607.24598},
  note          = {Preprint}
}